Mostrando entradas con la etiqueta ROUTE. Mostrar todas las entradas

julio 31, 2018

El comando "show ipv6 rip database"


Por Oscar Gerometta

Los comandos de monitoreo de protocolos de enrutamiento IPv6 son comandos específicos de cada protocolo. En el caso de RIPng el comando show ipv6 rip tiene una variantes específica de importancia que es show ipv6 rip database.

El comando en sí mismo fue introducido en IOS 10.0 y tuvo algunas modificaciones de consideración en IOS 12,2(15)T y IOS 15.1(2)S. La variante "database" fue introducida en IOS 12.2(3)T.
 
La adición del argumento "database" permite verificar la información correspondiente a las entradas de la tabla de rutas obtenidas por RIPng.

Un ejemplo de este comando en un dispositivo que implementa RIPng:

Router#show ipv6 rip one database
RIP process "one", local RIB
 2001:72D:1000::/64, metric 2
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs
 2001:72D:2000::/64, metric 2, installed
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs
 2001:72D:3000::/64, metric 2, installed
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs
     Ethernet1/2001:DB8::1, expires in 120 secs
 2001:72D:4000::/64, metric 16, expired, [advertise 119/hold 0]
     Ethernet2/2001:DB8:0:ABCD::1
 3004::/64, metric 2 tag 2A, installed
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs


Lectura del comando
Revisemos ahora el resultado de la ejecución del comando:

Router#show ipv6 rip one database

  • Pide la información almacenada en la base de datos que corresponde al proceso de RIPng etiquetado con el nombre "one".
RIP process "one", local RIB
  • "RIP process"
    Indica el nombre del proceso de RIPng al que corresponde la información de enrutamiento que se muestra a continuación.
 2001:72D:1000::/64, metric 2
  • "2002:72D:1000::/64"
    Prefijo IPv6 que identifica la red IPv6 de destino.
  • "metric"
    Cantidad de saltos a travesar para alcanzar la red de destino.
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs
  • "Ethernet2"
    Interfaz a través de la cual la ruta ha sido aprendida.
  • "2201:DB8:0:ABCD::1"
    Dirección IPv6 que corresponde al próximo salto a través del cual se alcanza la red destino.
  • "expires in"
    Tiempo en segundos antes de que la ruta expire.
 2001:72D:2000::/64, metric 2, installed
  • "installed"
    Ruta IPv6 que ha sido instalada en la tabla de enrutamiento IPv6 del dispositivo.
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs
 2001:72D:3000::/64, metric 2, installed
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs
     Ethernet1/2001:DB8::1, expires in 120 secs
 2001:72D:4000::/64, metric 16, expired, [advertise 119/hold 0]

  • "expired"
    La ruta está marcada como inaccesible (métrica = 16 saltos) por haber vencido el temporizador de espera.
  • "advertise"
    En el caso de una ruta "expirada", período de tiempo en segundos durante el cual la ruta será anunciada como inalcanzable.
  • "hold"
    Valor en segundos del temporizados de holddown que se le aplica a la ruta.
     Ethernet2/2001:DB8:0:ABCD::1
 3004::/64, metric 2 tag 2A, installed

  • "tag"
    Etiqueta asociada a la ruta IPv6 que se muestra.
     Ethernet2/2001:DB8:0:ABCD::1, expires in 168 secs

Tomado de http://librosnetworking.blogspot.com/2018/07/comandos-show-ipv6-rip-database.html

marzo 07, 2018

Estado de la implementación de IPv6


Por Oscar Gerometta

Periódicamente vuelvo a encontrarme con diferentes publicaciones en las que se pone en dudas o se cuestiona la implementación de IPv6. Incluso algunas que siguen considerándola como una propuesta a futuro que podría o no darse.

Ya muchas veces he abordado el tema en este blog, incluso he publicado un manual con los conceptos básicos de IPv6. Pero evidentemente es necesario cada tanto volver sobre el tema.


La implementación de IPv6 no es una posibilidad, es una realidad que no podemos desconocer. Hay mucha información disponible sobre el tema.


La implementación al día de hoy


Como dije, IPv6 no es un proyecto a futuro sino una tecnología ya implementada cuya penetración es creciente cada día. Así lo muestra la información disponible.

Un ejemplo. Google publica en línea el porcentaje de tráfico de sus data centers que utiliza IPv6. Este es el reporte al día de hoy que, como podemos ver, muestra que el 21,09% del tráfico de los data centers de Google es tráfico IPv6 nativo:


Esta información está disponible en línea para quien quiera consultarla en este enlace.

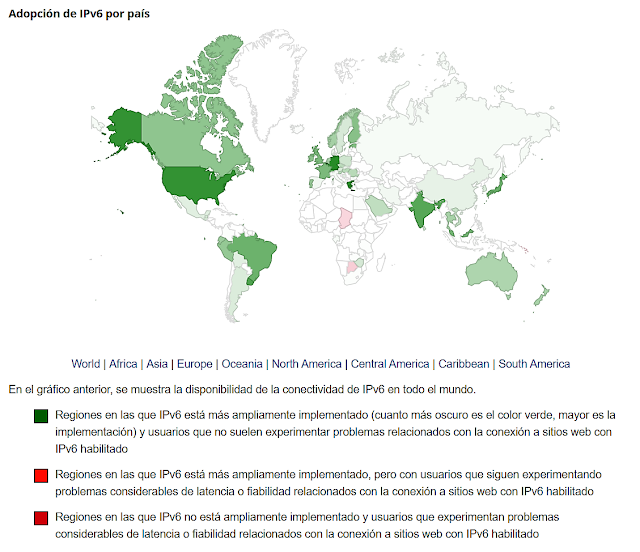
Si lo que queremos es conocer la disponibilidad de conectividad IPv6 a nivel global, este mapa puede servir de primera aproximación:


Una mirada rápida nos permite verificar que el despliegue actual está centrado en América del Norte, Brasil, Europa, India, Japón, Australia y otros países asiáticos. El país con mayor nivel de adopción en este momento es Bélgica con el 62,59% de sus usuarios conectados utilizando IPv6.


Se puede acceder a la información detallada, país por país, desde este enlace.


¿Qué pasa en América Latina?


Como muestra el mapa global, si bien América Latina no se encuentra a la cabeza de la implementación global, tampoco está a la cola de la misma. En los últimos años varios países han disparado sus procesos de adopción

La vista regional del estado de adopción está volcada en este mapa en el que la intensidad del color verde indica un porcentaje creciente de usuarios conectados a IPv6.


Si consideramos el porcentaje de usuarios conectados con IPv6 un índice adecuado de evaluación del proceso, el líder en la región es entonces Uruguay con un 28,4% de sus usuarios conectados a la red IPv6.


Claro que por sus dimensiones, población y peso en la región no podemos ignorar a Brasil que se presenta con un 23,5% de sus usuarios conectados a IPv6.


Lo que es posible verificar de la observación de la información histórica de implementación en la región es que la misma se ha comenzado a desarrollar con mayor intensidad a partir del año 2015.


Esto es para empresas, ¿no para conexiones domiciliarias?


Este es otro prejuicio falso respecto a la implementación de IPv6. No hay un Internet corporativo y otro hogareño. Claro que todo depende de nuestro proveedor de acceso.
 

Pero como un ejemplo, yo estoy en este momento utilizando una conexión hogareño de cable módem, y estoy conectado utilizando IPv6:


Y no se trata solamente de recibir direccionamiento IPv6 global unicast, sino que también opero utilizando IPv6 como primer opción:


Si querés saber si estás verdaderamente operando en la red IPv6 hay varios sitios que permiten verificar esto. Uno de ellos es el sitio de verificación en línea dispuesto por Google:


También es posible utilizar servicios en línea con un análisis más detallados como el de IPv6 Test:


¿Qué debemos esperar a futuro?


A futuro debemos esperar un despliegue creciente de IPv6. Tanto en el ámbito corporativo como en el hogareño.


  • Hace ya tiempo que se han agotado las direcciones IPv4 para seguir creciendo.
  • El despliegue de IoE es una realidad que ya está instalada y sigue creciendo.
  • El requerimiento de direccionamiento IP global es consecuentemente creciente.
  • La respuesta para los requerimientos actuales de entonces IPv6.
Podemos discutir la velocidad con la que se realiza el despliegue, pero ya no es posible poner en dudas que se ha de hacer y que debemos ponernos en esta línea de trabajo.

Para quienes mayores precisiones sobre el crecimiento, hay un sitio que hace proyecciones para el despliegue de IPv6 a nivel global y por países. De acuerdo a vyncke.org el despliegue previsible para los próximos 2 años, a nivel global, es el siguiente:


Poner en dudas la implementación de IPv6 parece, entonces, un acto de ignorancia. La pregunta, creo, no es ya si IPv6 se implementará o no sino cuándo la implementaremos y si estamos listos para hacerlo.

Enlaces útiles:


Tomado de: http://librosnetworking.blogspot.com/2018/03/estado-de-ipv6.html
       

enero 02, 2018

¿Qué información revela el comando show ip ospf interface?


Para analizar la información provista por este comando, tomaremos como ejemplo la siguiente topología:


Ejemplo de la salida del comando show ip ospf interface para la red mostrada en la imagen anterior:

Router1# show ip ospf interface ethernet 0
  Ethernet0 is up, line protocol is up 
  Internet Address 10.10.10.1/24, Area 0 
  Process ID 1, Router ID 192.168.45.1, Network Type BROADCAST, Cost: 10
  Transmit Delay is 1 sec, State BDR, Priority 1 
  Designated Router (ID) 172.16.10.1, Interface address 10.10.10.2
  Backup Designated router (ID) 192.168.45.1, Interface address 10.10.10.1
  Timer intervals configured, Hello 10, Dead 40, Wait 40, Retransmit 5
    Hello due in 00:00:06
  Index 1/1, flood queue length 0
  Next 0x0(0)/0x0(0)
  Last flood scan length is 2, maximum is 2
  Last flood scan time is 0 msec, maximum is 4 msec
  Neighbor Count is 1, Adjacent neighbor count is 1 
    Adjacent with neighbor 172.16.10.1  (Designated Router)
  Suppress hello for 0 neighbor(s)

Estado de la interfaz

Ethernet0 is up, line protocol is up 

La primera línea de la salida muestra los estados de interface a nivel de las capas 1 y 2. En este ejemplo, la interface ethernet0 detecta el portador en la línea y muestra la capa 1 como "is up" (está arriba).  El Line Protocol en la interfaz del ethernet0 confirma que la capa 2 está "is up" (está arriba). Para el funcionamiento apropiado, las interfaces deben estar en un estado up-up.

Área y dirección IP 

Internet Address 10.10.10.1/24, Area 0 
 
La segunda línea muestra la dirección IP configurada en esta interfaz y también, el área en la se encuentra esta interfaz. En el ejemplo antedicho, el ethernet0 tiene una dirección IP de 10.10.10.1/24 y está en la área OSPF 0.

ID de Proceso

Process ID 1

El identificador de proceso es el ID del proceso OSPF al cual la interfaz pertenece. El identificador de proceso es local al router, y dos routeres de la vencidad OSPF pueden tener diverso proceso OSPF ID. (A diferencia del EIGRP (enhanced interior gateway routing), donde ambos routers necesitan estar en el mismo sistema autónomo).

El software de Cisco IOS® puede funcionar con multiples procesos OSPF en el mismo router, y el identificador de proceso distingue simplemente un proceso del otro. El identificador de proceso debe ser un entero positivo. En este ejemplo, el identificador de proceso es 1.

ID del router 

Router ID 192.168.45.1 
 
El router para OSPF ID es una dirección IP de 32 bits seleccionada al inicio del proceso OSPF.

Se puede designar un router ID manualmente con el comando router-id bajo router ospf process-id. 
Si no se configura Router ID y se configura una interface de Loopback, la IPv4 es tomada como la identificación del router. Si hay múltiples interfaces de Loopback, la dirección IPv4 de loopback más alta es el Router ID.

Si no se configura el Router ID y tampoco existen interfaces de Loopback configuradas, la dirección IPv4 más alta configurada en las interfaces activas del router es tomado como el Router ID.


Una vez que se elige el Router ID, no cambia a menos que el proceso OSPF se reinicie.

En este ejemplo, 192.168.45.1 es el router para OSPF ID.

Tipo de red

Network Type BROADCAST
 
En el ejemplo, el tipo de red OSPF es  BROADCAST, utiliza las capacidades de multidifusión OSPF. Con este tipo de red se seleccionan un router designado (DR) y un router designado de respaldo (BDR).

Para que los Routers en una interfaz puedan formar una adyacencia de vecinos, el tipo de red para debe coincidir.

Algunos de los tipos de red OSPF posibles son:
  • PUNTO A PUNTO (por ejemplo, las interfaces de dos Routers conectado a través del E1 o de los links T1)
  • NO-BROADCAST (por ejemplo el X.25 y Frame Relay)
  • POINT-TO-MULTIPOINT (tal como Frame Relay)
Para configurar el tipo de red OSPF a un tipo con excepción del valor por defecto para un media dado, utilice el comando ip ospf network {broadcast | non-broadcast | {point-to-multipoint [non-broadcast] | point-to-point}}.

Costo

Cost: 10
 
Esta es la métrica de OSPF. El costo se calcula mediante la fórmula:
  • 108/ancho de banda (en los bits por segundo [bps])
En la fórmula, el ancho de banda refiere al ancho de banda de la interfaz en los BPS, y 108 es el ancho de banda de referencia.

En el ejemplo, el ancho de banda del ethernet0 es 10 Mbps, que es igual a 107. La fórmula resulta 108/107, resultando en un costo de 10.

Utilice comando ip ospf cost para configurar explícitamente el costo de una interfaz.


Demora de transmisión

Transmit Delay is 1 sec

El retardo de la transmición es la cantidad de tiempo que espera OSPF antes de inundar un anuncio del estado del enlace (LSA) en el link.

Antes de transmitir un LSA, la antiguedad del link-state es multiplicada por este número. En este ejemplo, el retardo del transmitir es 1 segundo, que es el valor predeterminado.

Estado 

State BDR
 
Este campo define el estado del link y puede ser cualquiera de estos:
  • DR — El router es el DR en la red con la cual esta interfaz está conectada, y establece las adyacencias OSPF con el resto del Routers en esta red de broadcast. En este ejemplo, este router es el BDR en el segmento Ethernet con el cual la interfaz del ethernet0 está conectada.
  • BDR — El router es el BDR en la red con la cual esta interfaz está conectada, y establece las adyacencias con el resto del Routers en la red de broadcast.
  • DROTHER — El router es ni el DR ni el BDR en la red con la cual esta interfaz está conectada, y establece las adyacencias solamente con el DR y el BDR.
  • Waiting — La interfaz está esperando para declarar el estado del link como DR. La cantidad de tiempo las esperas de la interfaz es determinada por el temporizador de la espera. Este estado es normal en un entorno del acceso múltiple sin broadcast (NBMA).
  • Point-to-Point — Esta interfaz es de punto a punto para el OSPF. En este estado, la interfaz está completamente funcional y comienza a intercambiar los paquetes de saludo con todos sus vecinos.
  • Point-to-Multipoint — Esta interfaz es punto a múltipunto para el OSPF.

Prioridad

Priority 1 

Esta es la prioridad OSPF que ayuda a determinar los roles de DR y BDR en la red con la cual esta la interfaz conectada.

La prioridad es un campo de 8 bits basado en qué DR y BDR se eligen. El router con la prioridad más alta hace el DR. Si las prioridades son iguales, el router con el router ID más alto se elije como DR. Por defecto la prioridad está fijada en 1.

Utilice el comando en el modo de configuración de interface ip ospf priority number value para establecer la prioridad del router para OSPF. Un router con una prioridad de 0 nunca participa en el proceso de elección DR/BDR y no se convierte nunca en un DR/BDR.

Router designado

Designated Router (ID) 172.16.10.1

Este es el Router ID del DR para esta red de broadcast. En el ejemplo, es 172.16.10.1.

Dirección de la interfaz

Interface address 10.10.10.2

Esta es la dirección IP de la interfaz DR en esta red de difusión. En el ejemplo, el direccionamiento es 10.10.10.2, que es router 2.

Router designadode respaldo

Backup Designated router (ID) 192.168.45.1

Esta es la ID del router del BDR para esta red de transmisión. En el ejemplo, es 192.168.45.1.

Dirección de la interfaz

Interface address 10.10.10.1

Esta es la dirección IP de la interfaz BDR en esta red de broadcast. En el ejemplo, es router1.

Intervalos del temporizador

Timer intervals configured, Hello 10, Dead 40, Wait 40, Retransmit 5
    Hello due in 00:00:06

Estos son los valores de los temporizadores OSPF:
  • Hello - intervalo en segundos que un router envía un paquete OSPF de saludo. En links de transmisión y punto a punto, el valor predeterminado es de 10 segundos. En el NBMA, el valor por defecto es 30 segundos.
  • Dead—Tiempo de espera en segundos antes de declarar la inactividad de un vecino. De forma predeterminada, el intervalo muerto de temporización es equivalente a cuatro veces el intervalo de temporización de saludo.
  • Wait - Intervalo de temporización de espera. Provoca que la interfaz abandone el período de espera y seleccione un DR de la red. Este temporizador es siempre igual al intervalo de temporizador de emergencia.
  • Retransmitir—El tiempo que hay que esperar antes de retransmitir un paquete de descripción de base de datos (DBD) cuando éste no ha sido reconocido.
  • Hello Due adentro — Un paquete OSPF de saludo se envía en esta interfaz después de este tiempo. En este ejemplo, hola se envía tres segundos a partir del tiempo que se publica la interfaz OSPF del IP de la demostración.

Cantidad de vecinos

Neighbor Count is 1

Éste es el número de vecinos OSPF descubiertos en esta interfaz. En este ejemplo, este router tiene un vecino en su interfaz del ethernet0.

Cuenta de vecino adyacente

Adjacent neighbor count is 1 
Adjacent with neighbor 172.16.10.1  (Designated Router)
 
Éste es el número de Routers que ejecuta el OSPF que sea completamente adyacente con este router. Adyacente significa que sus bases datos están completamente sincronizadas.

En este ejemplo, este router ha formado una adyacencia OSPF con un vecino en su interfaz del ethernet0.

Suprimir hello

Suppress hello for 0 neighbor(s)
 
Cuando se establece una conexión IP OSPF sobre enlaces ISDN, los paquetes OSPF de saludo se suprimen para prevenir que el link continuamente cambie al estado "up". En este ejemplo, la salida se muestra para una interfaz de Ethernet; por lo tanto, los paquetes de saludo no necesitan ser suprimidos para ninguno de los vecinos.

Índice

Index 1/1
 
Éste es el índice de las listas de la inundación de la interfaz (área/sistema autónomo) usadas. En el ejemplo, el valor es 1/1.

Longitud de cola de inundación

flood queue length 0
 
Este es el número de LSA que esperan para ser inundados sobre una interfaz. Del ejemplo, el número de LSA que esperan para ser inundado sobre la interfaz de Ethernet es 0.

Next (Siguiente)

Next 0x0(0)/0x0(0)
 
Este es el puntero a los LSA siguientes (índice) a inundar. Refiere a las listas de la inundación.

Longitud/máximo del último escaneo de inundación

 Last flood scan length is 2, maximum is 2

Este es el tamaño de la lista más reciente de LSA que ha sido inundada y el tamaño máximo de la lista. Cuando se usa "pacing", se transmite un LSA  a la vez.

Tiempo/máximo de escaneo de última inundación

Last flood scan time is 0 msec, maximum is 4 msec

Este es el tiempo que tomó realizar la última inundación y el tiempo máximo registrado para las inundaciones.

Información Relacionada

Tomado de: https://www.cisco.com/c/es_mx/support/docs/ip/open-shortest-path-first-ospf/13689-17.html - Con mejoras del editor del blog.

noviembre 04, 2017

Distancia Administrativa en diferentes fabricantes


Por Oscar Gerometta

Al considerar el algoritmo de selección de la mejor ruta utilizado en dispositivos Cisco IOS, el primer criterio para definir la mejor ruta a un destino cuando se presentan varias rutas diferentes es la confiabilidad de la información de enrutamiento que, en IOS, es representada a través del parámetro denominado Distancia Administrativa.
 
Sin embargo, un punto que olvidamos considera siempre es que la Distancia Administrativa es un parámetro propietario de Cisco. IOS asigna un valor de DA por defecto a cada protocolo de enrutamiento que es modificable luego por configuración.
 
Otros fabricantes siguen el mismo criterio utilizando un parámetro al que denominan Preferencia y que tiene el mismo valor: califica la confiabilidad de la información obtenida. 

El valor asignado por defecto a cada protocolo cambia en diferentes fabricantes aunque, en términos generales, la graduación de confianza que merece cada protocolo es semejante.
 
El siguiente gráfico presenta los valores que se asigna a cada fuente en diferentes fabricantes.


Tomado de: http://librosnetworking.blogspot.com/2017/11/distancia-administrativa-en-diferentes.html

agosto 09, 2016

Oferta Apunte rápido CCNP Route - 150 Bolivianos


* Oferta vádida para Bolivia, hasta agotar stock

El Apunte Rápido desarrolla de modo sintético la totalidad del temario del examen de certificación. 

Se incluiye un anexo aparte un breve desarrollo sobre el protocolo IS-IS. Si bien IS-IS no es parte del temario del examen de certificación es un protocolo de enrutamiento que tiene importancia creciente en algunos entornos específicos.

En este manual se encuentran todos los contenidos necesarios para completar la preparación del examen de certificación.

Si eres un alumno de Academia o de Learning Partner, es posible que este manual te sea suficiente y al momento de estudiar utilices los materiales oficiales que recibiste durante tu cursada para aclarar dudas o buscar referencias necesarias.

Para quienes estudian por sí mismo (auto-estudio), este manual les sirve como referencia de base y deberán complementarlo con investigación personal.

No incluye herramientas pedagógicas tales como mapas conceptuales, resúmenes, notas, cuestionarios, anexos de ejercicios, etc.

Fecha de publicación: 21 de septiembre de 2015
Autor: Oscar A. Gerometta
CCSI / CCNA R&S / CCDA / CCNAwir / CCNA sec. / CCBF.
Creador –en el año 2000- del primer curso de apoyo para alumnos de Cisco Networking 
Academy program que se preparan a rendir su examen de certificación CCNA, logrando entre sus alumnos un nivel de aprobación superior al 95%.

Texto:
Se trata de una síntesis de los contenidos de estudio comprendidos en el nuevo examen de certificación ROUTE 300-101.

Está alineado al examen CCNP ROUTE 300-101. 


Contenidos:
  • El examen de certificación ROUTE.
  • Conceptos básicos de enrutamiento IP.
  • Implementación de RIPng.
  • Implementación de EIGRP.
  • Implementación de OSPF.
  • Redistribución de rutas.
  • Implementación de control de rutas.
  • BGP - Conexión corporativa a Internet.
  • Protección de routers y protocolos de enrutamiento.
  • Anexo 1: Glosario de siglas.
  • Anexo 2: Protocolo IS-IS.
Cantidad de páginas: 265

Algunas notas sobre esta versión:
  • Cubre la totalidad del temario.
  • Incluye enrutamiento IPv6.
  • Se incluye tanto la configuración de OSPFv3 como Named EIGRP.
  • IS-IS no es parte del temario del examen, ha sido incluido solo como información complementaria.
  • Por tratarse de un Apunte Rápido no incluye laboratorios.
Mas información: libros.networking.bolivia@gmail.com - El costo incluye despacho por flota.

marzo 18, 2016

MPLS: El concepto de PHP (Penultimate Hop Popping)


En MPLS, PHP viene del inglés penultimate hop popping (Algo como "Remover en el penultimo salto") y en el contexto de MPLS significa remover la etiqueta un salto antes del destino del paquete. Se refiere al proceso mediante el cual la etiqueta mas externa de un paquete etiquetado con MPLS es removida por un LSR (Label Switch Router) antes que el paquete sea pasado a un router vecino EDGE (LER - Label Edge Router).


El proceso es importante en un entorno de MPLS VPN de capa 3 porque reduce la carga en el LER. Si no fuera por este proceso, el router LER tendría que realizar al menos dos inspecciones de etiquetas:

  1. La etiqueta externa, que identifica que el paquete estaba destinado a que le retiren la etiqueta en este router.
  2. La etiqueta interna, para identificar cual instacia de router VRF ( Virtual Routing and Forwarding ) va a ser usada para realizar la siguiente busqueda IP.
En una red grande esto podría resultar en un CPU muy cargado en el router LER, alcanzando niveles de saturación inaceptables.

Teniendo PHP en un router LER en los LSRs conectados a el, la carga es distribuida hacia los routers vecinos.

Para evitar este trabajo extra en el ultimo router LSR, MPLS usa una característica llamada PHP ( penultimate hop popping ) (Penultimate simplemente significa "1 menos que el último")


Entonces el penúltimo salto no es el ultimo router LSR que procesa un paquete etiquetado, es el segundo antes del ultimo que procesará un paquete etiquetado. PHP hace que el penúltimo router LSR remueva la etiqueta externa, de forma que el ultimo LSR - o el último salto si prefiere - recibe un paquete que solo tiene la etiqueta VPN. 

Con solo esta única etiqueta, el router EGRESS PE necesita solamente hacer una única inspección en la Base de Información de Conmutación de etiquetas ( Label Forwarding Information Base - LFIB).


PHP es usado solamente para subredes conectadas directamente o rutas agregadas. 

En el caso de una interface conectada directamente, la inspección de capa 3 es necesaria para obtener la información correcta de siguiente salto para un paquete que es enviado hacia un destino directamente conectado.

Si el prefijo es una ruta agregada, una inspección de capa 3 es también necesaria para encontrar la ruta mas específica que es usada para enrutar el paquete hacia su destino correcto. En todos los demás casos, la información de salida de capa 2 está disponible en la LFIB y, en consecuencia, una inspección de capa 3 no es necesaria y el paquete puede ser conmutado por etiqueta.

Con PHP el router EDGE-LSR puede requerir una operación de retiro de etiqueta de sus vecinos que están camino al backbone de la red. Por ejemplo, en una súper red grande, el router Washington remueve la etiqueta del paquete y envía un paquete IP puro al router New York. Entonces el router New York realiza una inspección simple de capa 3 y enruta el paquete hacia su destino final.


Tomado de: http://www.networksbaseline.in/2016/02/the-concept-of-php-penultimate-hop.html

febrero 15, 2016

Protocolos de enrutamiento de red


Una vez que un(a) ingeniero(a) ha logrado un conocimiento básico de como funciona el enrutamiento (reenvío) de paquetes, el paso siguiente es configurar el método de enrutamiento. En este post se consideran las principales categorías de configuración de enrutamiento y se habla de diferentes tipos de protocolos de enrutamiento dinámico que son frecuentemente utilizados.

Como configurar el enrutamiento de la red

Existen dos principales formas de configurar el enrutamiento: estático y dinámico.

El enrutamiento estático generalmente es usado en redes pequeñas, donde la cantidad de routers a ser configurados es pequeña. De todos modos, el enrutamiento estático es algunas veces usado en redes grandes como una pequeña pieza de una infraestructura de enrutamiento dinámicamente controlada. En estos casos, las rutas estáticas definen típicamente rutas por defecto o tráfico que se dirige de manera controlada de una red a otra.

El Enrutamiento Dinámico está pensado para poder manejar automáticamente cambios en la red a medida que la topología va cambiando y es típicamente utilizado en todos los tipos de redes que no hemos mencionado previamente.

Como un ejemplo, demos un vistazo a la siguiente imagen. Este ejemplo muestra un número de caminos diferentes que un mensaje puede tomar cuando sale desde el router R1 hacia el R6. Por ejemplo, el tráfico podría ir por  R1 > R2 > R4 > R6 ó podría ir por R1 > R3 > R4 > R6.


Cuando se configura enrutamiento estático, típicamente el(la) ingeniero(a) configura una sola ruta para alcanzar el destino. En este caso, para llegar de R1 a R6 usando el camino por R2 y R4 la ruta tendría que ser configurada en R1, R2 y R4 para la ruta de ida y otra ruta será necesaria en R6, R4 y R2 para el camino de regreso. Tenga en mente que esta ruta es solo para una única red de destino.

Para poder alcanzar cada destino potencial dentro de la red, el(la) ingeniero(a) inicialmente necesita calcular las mejores rutas para cada uno de los posibles destinos y luego configurar individualmente cada ruta a lo largo de cada "mejor camino". Obviamente este proceso puede tomar mucho tiempo. Piense en ¿que pasaría si ocurre una falla a lo largo del "mejor camino" calculado?.

Esta es la razón por la que se usan protocolos de enrutamiento Dinámico en redes grandes y enrutamiento estático en redes pequeñas o en casos específicos. Los protocolos de enrutamiento dinámico eliminan el problema de la configuración manual, han sido diseñados para manejar topologías complejas y para lidiar con fallas en la red sin la necesidad de atención por parte del(la) administrador(a) de la red.

Tipos de Enrutamiento Dinámico

Luego de haber decido usar un protocolo de enrutamiento dinámico, el(la) ingeniero(a) tiene que tomar algunas decisiones adicionales relacionadas con el tipo de protocolo de enrutamiento dinámico. 

En el nivel mas alto existen dos categorías de protocolos de enrutamiento dinámico: Protocolos de Gateway Exterior (exterior gateway protocols EGPs) y Protocolos de gateway Interior (interior gateway protocols IGPs). 

 
Los EGPs conectan multiples dominios de red, se llaman Exterior porque el protocolo es exterior a los dominios de red. (Un dominio en este caso es una organización específica, un Service Provider o una red bajo una misma administración. También se llama un Sistema Autónomo (AS) ).

Los IGPs manejan el enrutamiento dentro de estos dominios de red. Estos protocolos son los más comunes y cada compañía con una red maneja su propio dominio de red.

Las redes modernas usan solo un protocolo EGP: el Border Gateway Protocol (BGP). 

Como es de esperar, existen varios diferentes IGPs y la elección de uno de ellos dependerá de los requerimientos de cada red. Los más populares IGPs son cuatro:
  • Open Shortest Path First (OSPF)
  • Enhanced Interior Gateway Routing Protocol (EIGRP)
  • Intermediate System to Intermediate System (IS-IS)
  • Routing Information Protocol (RIP)

Estos protocolos EGP e IGP están categorizados en tres diferentes tipos de protocolos de enrutamiento: Vector-distancia, Estado-enlace y Vector-ruta. 

Existen un numero importante de diferencias entre estos tipos, los cuales vamos a ver en las siguientes tres secciones.

Protocolos Vector-distancia

Existen algunas características asociadas con los protocolos de enrutamiento Vector-distancia tradicionales:
  • La vista que un Router tiene de la red es solamente la que ha sido descubierta a partir de lo que conocen sus vecinos (También llamado "enrutamiento por rumor").
  • El Router envía una versión completa de su tabla de enrutamiento a sus vecinos en intervalos periódicos
  • Toman un tiempo largo en lograr la convergencia cuando ocurre una falla porque las actualizaciones solo se envían en intervalos regulares
  • En comparación con los protocolos Estado-enlace, los protocolos de Vector-distancia tienen una probabilidad mayor de causar bucles de enrutamiento (Routing loops).

 
El único protocolo moderno que conserva las características tradicionales de Vector-distancia es RIP. Este protocolo envía cada 30 segundos una copia completa de su tabla de enrutamiento a través de todas las interfaces habilitadas con RIP. Una vez que recibe una actualización desde uno de sus vecinos, instala la información recibida en su tabla de enrutamiento (asumiendo que no hay confictos). Si pasa algo y la ruta queda inalcanzable, la ruta permanece en la tabla de enrutamiento por al menos 180 segundos (temporizador de invalido por defecto) antes de ser marcada como "inalcansable". Esta técnica hace lenta la convergencia de una ruta que ha fallado y retraza el tráfico que podría haber sido enrutado por una ruta alternativa.

RIP tiene tres versiones: RIP versión 1 (RIPv1), RIP versión 2 (RIPv2) y RIP next generation (RIPng). La forma de operar de estas tres versiones es muy similar pero hay algunas diferencias:

  • RIPv1 envia sus actualizaciones en Broadcast, mientras que RIPv2 usa Multicast evitando que los dispositivos "no-RIP" tengan que procesar paquetes extra cada 30 segundos.
  • RIPv2 soporta redes subneteadas (Sin clase, Classless, CIDR, VLSM) mientras que el RIPv1 solo soporta enrutamiento con clase (Classfull)
  • RIPng trabaja de forma similar a RIPv2 pero para direcciones IPv6

EIGRP es tecnicamente un protocolo Vector-distancia y también se basa en la información de sus vecinos, pero EIGRP tiene varias características sobresalientes que lo hacen actuar como un protocolo Estado-enlace. Por esta razón a veces se considera a EIGRP como un protocolo híbrido, usando recursos de ambos tipos de protocolos. Otras características avanzadas incluyen la creación de adyacencias y actualizaciones parciales disparadas, por mencionar dos de ellas.


Para evitar los bucles de enrutamiento se usan dos métodos diferentes: Envenenamiento en reversa y Horizonte dividido. Envenenamiento en reversa es usado cada vez que una nueva ruta es aprendida de un vecino, cuando esto ocurre el router manda automáticamente una actualización de ruta de vuelta a la interface por la cual aprendió de esta ruta pero con una métrica infinita. Esto previente que el vecino use esa ruta que acaba de aprender.
 
Horizonte dividido es también usado cuando un router publica rutas fuera de sus interfaces. Con el horizonte divido, si una ruta es apredida por medio de una interface entonces no se envía la misma información sobre esa ruta por la misma interface.

Protocolos de Estado-enlace

Los protocolos de Estado-enlace a cada router en una red una vista completa de toda la red, permitiendo que cada router tenga la habilidad de calcular la mejor ruta a cada punto de la red. Todos los protocolos de enrutamiento de Estado-enlace modernos usan el algorimo SPF de Dijkstra.

 Los protocolos de Estado-enlace trabajan estableciendo adyacencias de vecinos con los routers conectados e intercambiando una copia de las redes conocidas (no solamente el contenido de su tabla de enrutamiento) con esos vecinos. Todas las actualizaciones que son recibidas son inmediatamente reenviadas a todos los otros vecinos conectados.

Ambos protocolos, el OSPF e IS-IS, son protocolos de Estado-enlace y ambos usan el algoritmo de Dijkstra para construir el mapa con las mejores rutas a todos los puntos de la red. De todos modos, su configuración es muy distinta, y la elección de una red sobre otra está basada principalmente en los requerimientos de una red específica.

OSPF es mayormente implementado en empresas mientras que IS-IS es mas popular en redes de Service Provider.

Protocolos de Vector-ruta


El único protocolo Vector-ruta en uso hoy en día es BGP. Cuando BGP es configurado, va a guardar una copia de todas los Sistemas autónomos (AS) alcanzables (AS es el término BGP para los Dominios de red de los que se habló antes en este post) y el camino para alcanzarlos. Esta información le da al protocolo una vista clara de cuales redes pueden alcanzarse y cual es el camino informado para cada una.


Un router BGP también usa un número diferente de atributos de ruta para determinar cual ruta finalmente usará para alcanzar un destino específico. Dado que BGP es un EGP y es usado para enrutar entre dominios de enrutamiento, es frecuente que existan múltiples caminos hacia un destino. Usando una combinación de estos atributos, un Router elige la ruta que usará.

Resumen

La opción de usar un método de enrutamiento dinámico o estático es determinado frecuentemente por el tamaño de la red. Si la red es muy pequeña (unos cuantos nodos) una solución con enrutamiento estático puede funcionar. De todos modos, aunque la red sea pequeña, un método de enrutamiento dinámico puede ser usado sin tener que hacer mucha configuración y este va a seguir siendo útil a medida que la red crezca.


El tipo de protocolo de enrutamiento dinámico a ser usado, finalmente, puede depender de la marca del equipo de enrutamiento que esté en uso. OSPF y EIGRP son dos de los protocolos de enrutamiento mas populares usados en redes empresariales. Uno de los dos, el EIGRP, es considerado mas sencillo de configurar, pero hasta hace no mucho tiempo ha sido un protocolo propietario de Cisco y en consecuencia no estaba disponible en equipos de otras marcas.

Si usted está instalando solamente equipo Cisco, la selección dependerá mas del entrenamiento que haya recibido su personal de redes y cual protocolo entienden mejor.

----------------------------------------
Post basado en el artículo de Sean Wilkins, publicado por CiscoPress en : http://www.ciscopress.com/articles/article.asp?p=2435847 con aportes del editor del blog

Traducido por José R. Torrico Gumucio - Cisco Networking Academy Instructor